Mengubah kartu grafis konsumen kelas atas menjadi akselerator pusat data berskala industri ibarat mempreteli mesin supercar berdaya tinggi untuk dipaksa beroperasi tanpa henti di dalam lokomotif barang. Keduanya sama-sama dirancang untuk memproses tenaga dalam jumlah besar, namun tuntutan ketahanan siklus beban kerja, dinamika disipasi panas, dan arsitektur sirkuit interkoneksinya berada pada kutub rekayasa yang sangat kontras. Kabar mengenai lenyapnya pasokan GeForce RTX 5090 dari rak ritel global yang berakhir di fasilitas modifikasi perangkat keras di daratan China bukan sekadar drama kelangkaan stok biasa, melainkan cerminan benturan nyata antara kebijakan pembatasan ekspor semikonduktor dengan kebutuhan komputasi kecerdasan artifisial yang kian tak terbendung.
Litografi TSMC 4N dan Anatomi Silikon Monolitik GB202
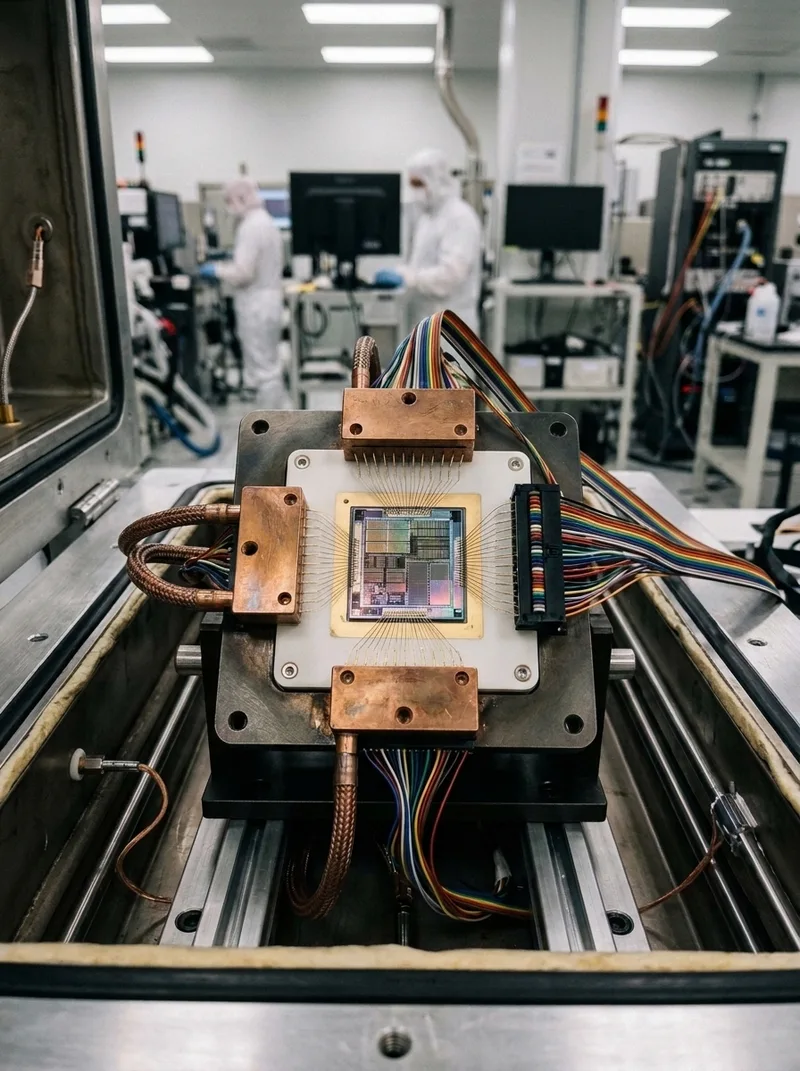
Di jantung GeForce RTX 5090 bersemayam cetak silikon monolitik berkode GB202 yang diproduksi menggunakan proses litografi kustom 4N dari Taiwan Semiconductor Manufacturing Company (TSMC). Node fabrikasi kelas 5 nanometer yang disempurnakan ini memungkinkan penataan puluhan miliar transistor dengan kerapatan logika yang mendekati ambang batas fisik reticle limit. Bagi industri komputasi grafis konsumen, die silikon ini menawarkan lompatan besar dalam rendering rasterisasi dan penelusuran sinar real-time. Namun bagi entitas pengembang model bahasa besar di kawasan Asia Timur yang terisolasi dari akses resmi akselerator enterprise seperti Hopper H100 atau Blackwell B200, GB202 dipandang sebagai tambang emas komputasi matriks yang sangat berharga untuk tugas inferensi dan penyesuaian model.
Keunggulan arsitektural GB202 bertumpu pada konfigurasi Streaming Multiprocessor yang masif, dipadukan dengan generasi terbaru Tensor Core yang mendukung format presisi rendah FP8 dan FP4. Dalam beban kerja inferensi model bahasa modern, penggunaan kuantisasi FP4 memungkinkan throughput pemrosesan token meningkat hingga berlipat ganda tanpa mengorbankan akurasi penalaran secara signifikan. Kecepatan transmisi data ditopang oleh subsistem memori GDDR7 berkapasitas 32 gigabita yang beroperasi melalui bus antarmuka selebar 512-bit. Dengan adopsi modulasi pensinyalan Pulse Amplitude Modulation 3-level (PAM3), memori GDDR7 mampu menembus bandwidth teoretis hingga melampaui 1,7 terabita per detik. Angka ini menjembatani jurang performa yang selama ini membatasi pemrosesan tensor berukuran raksasa pada platform kartu non-enterprise.
| Parameter Arsitektur | RTX 5090 Standar Konsumen | RTX 5090 Modifikasi Server China | NVIDIA Hopper H100 PCIe (Enterprise) |
|---|---|---|---|
| Node Litografi | TSMC 4N Kustom (5nm class) | TSMC 4N Kustom (5nm class) | TSMC 4N Kustom (5nm class) |
| Jenis & Kapasitas Memori | 32 GB GDDR7 (PAM3) | 32 GB / 64 GB GDDR7 Modifikasi | 80 GB HBM3e (CoWoS Interposer) |
| Lebar Bus & Bandwidth | 512-bit, ~1.790 GB/s | 512-bit, ~1.790 GB/s | 5.120-bit, ~2.000 - 3.350 GB/s |
| Thermal Design Power (TDP) | 600 Watt (Maksimum) | 450 - 550 Watt (Power Clamping) | 350 Watt (Pasif Rack Server) |
| Form Factor & Pendingin | 3.5 hingga 4-Slot Aksial Terbuka | 2-Slot Blower / Liquid Manifold | 2-Slot Pasif Server Enclosure |
| Interkoneksi Multi-Node | PCIe Gen 5 x16 (Tanpa NVLink) | PCIe Switch PEX + RoCE v2 | NVLink 900 GB/s Bi-directional |
Rekayasa Ulang BGA dan Tantangan Disipasi Termal 600 Watt
Alasan utama mengapa fasilitas manufaktur sekunder di Shenzhen dan Dongguan membongkar kartu grafis ritel terletak pada ketidaksesuaian dimensi fisik pendingin bawaan dengan rak server standar. Varian kartu grafis ritel dari vendor pihak ketiga umumnya memiliki ketebalan tiga hingga empat slot ekspansi dengan sistem kipas aksial terbuka berdiameter besar. Desain pendingin konsumen tersebut membuang udara panas ke segala arah di dalam casing komputer desktop. Jika kartu berdimensi jumbo semacam itu dipasang berjejer di dalam sasis server 2U atau 4U, turbulensi udara panas akan berputar tanpa ventilasi keluar yang memadai, memicu kenaikan suhu ekstrem seketika hingga unit mengalami thermal throttling parah dalam hitungan menit.
“Pengalihan silikon kelas konsumen ke dalam kluster komputasi industri membuktikan bahwa pembatasan geopolitik selalu kalah cepat dibandingkan kelenturan rekayasa perangkat keras di pasar sekunder.” &mdash. Kurniawan, S.S., M.Si., Lead Writer Exora News.
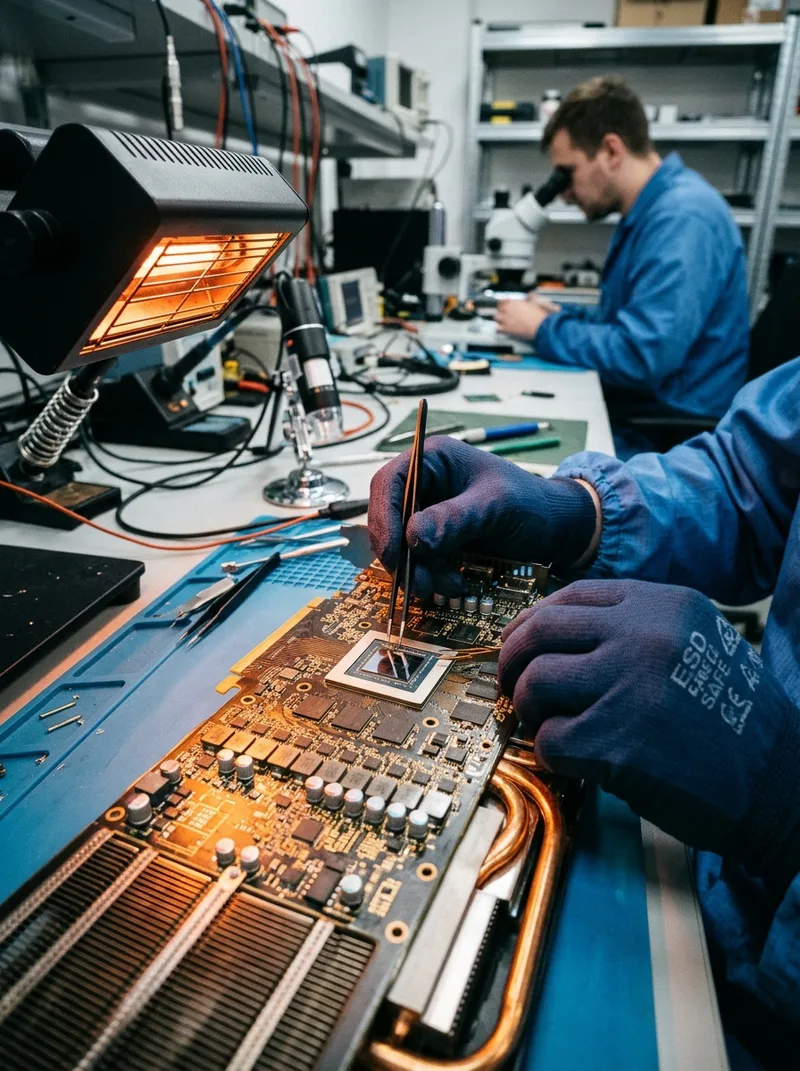
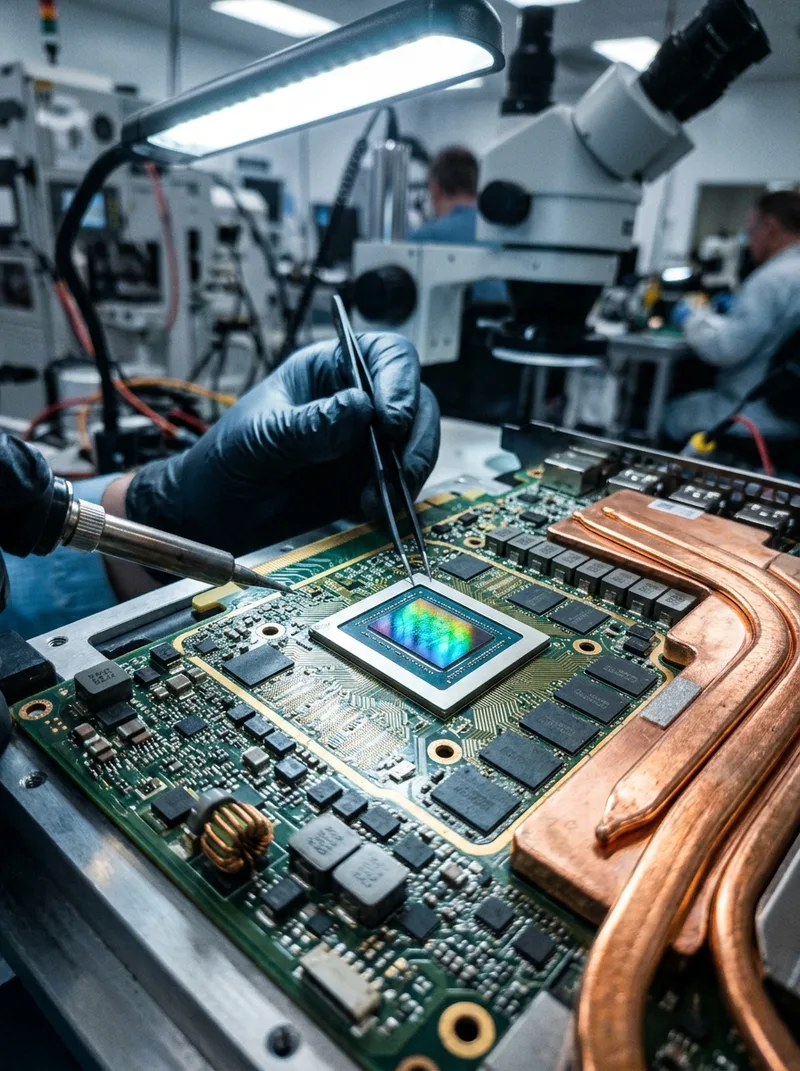
Untuk mengatasi kendala tata ruang sasis server, para teknisi di pabrik modifikasi melakukan operasi rekayasa tingkat lanjut dengan mencopot paket Ball Grid Array (BGA) silikon GB202 serta chip memori GDDR7 menggunakan stasiun desoldering inframerah presisi tinggi. Proses ini menuntut kontrol profil pemanasan yang luar biasa ketat. Deviasi suhu beberapa derajat Celcius saja dapat merusak lapisan dielektrik interkoneksi tembaga di dalam substrat silikon atau memicu pembengkokan termal mikroskopis yang merusak ribuan bola solder SAC305. Setelah proses reballing tuntas, komponen tersebut dipasang kembali ke papan sirkuit cetak kustom dua slot yang dilengkapi ruang uap tembaga murni dan turbin blower lateral berkecepatan tinggi.
Tantangan terbesar dalam merancang modul blower dua slot ini adalah disipasi daya termal yang mencapai 600 Watt. Sebagai perbandingan, akselerator enterprise murni dirancang dengan efisiensi daya per watt yang sangat disiplin serta batas daya termal yang jarang melampaui 350 hingga 450 Watt untuk varian pendinginan udara pasif. Untuk mencegah hotspot silikon menembus ambang batas kritis 95 derajat Celcius dan menjaga suhu sambungan memori GDDR7 tetap berada di bawah 105 derajat Celcius, teknisi server sering kali menerapkan pembatasan daya permanen pada tingkat vBIOS ke kisaran 450 hingga 500 Watt. Penurunan daya ini mengorbankan frekuensi boost puncak sekitar lima hingga delapan persen, namun menghasilkan kestabilan termal yang sangat krusial untuk operasi inferensi tanpa henti selama ribuan jam.
Integritas Sinyal GDDR7, Interkoneksi PCIe, dan Batasan Firmware
Pemindahan chip memori GDDR7 ke papan sirkuit kustom menghadirkan tantangan integritas sinyal listrik berfrekuensi tinggi. Modulasi PAM3 beroperasi dengan mentransmisikan tiga level tegangan berbeda, yang berarti margin kesalahan tegangan dan toleransi jitter waktu menjadi jauh lebih sempit dibandingkan modulasi NRZ biner konvensional. Setiap jalur konduktor tembaga pada papan sirkuit cetak baru harus dirancang dengan pencocokan panjang impedansi presisi sub-milimeter serta lapisan dielektrik bermutu tinggi dengan faktor disipasi ultra-rendah. Cacat kecil pada perutean jalur sinyal dapat memicu hilangnya sinkronisasi data antar kanal, menyebabkan bit-error rate melonjak, atau bahkan memicu kegagalan inisialisasi memori saat modul dinyalakan.
Hambatan arsitektural berikutnya adalah ketiadaan antarmuka fisik NVLink pada seri GeForce kelas konsumen. NVIDIA sengaja meniadakan port penghubung koheren tersebut demi mengunci segmen pasar kartu workstation dan data center enterprise. Tanpa NVLink, komunikasi antar-GPU dalam satu node server harus bertumpu sepenuhnya pada jalur PCIe Gen 5 x16. Guna meminimalkan latensi transfer bobot model antar-akselerator, pabrikan server rakitan menyematkan chip sakelar PCIe mutakhir seperti Broadcom PEX ke dalam backplane server. Arsitektur ini didukung integrasi kartu jaringan berkecepatan 400 Gbps yang menjalankan protokol Remote Direct Memory Access over Converged Ethernet (RoCE v2), memungkinkan transfer data langsung antar-GPU tanpa membebani prosesor utama.
Dari perspektif perangkat lunak dan firmware, kartu hasil modifikasi ini beroperasi di zona abu-abu. Enkripsi vBIOS dan tanda tangan digital driver NVIDIA mencegah modifikasi sewenang-wenang terhadap batas daya dan tabel voltase pabrikan. Untuk menyiasatinya, para perekayasa di China memanfaatkan shim driver berbasis kernel Linux yang memodifikasi panggilan API manajemen perangkat keras pada runtime sistem operasi. Langkah ini memungkinkan kluster mendeteksi dan mengelola kartu secara paralel di lingkungan orkestrasi kontainer seperti Kubernetes, meskipun kartu tersebut tetap dikenali oleh sistem operasi sebagai perangkat grafis konsumen biasa dan bukan akselerator enterprise resmi.
Distorsi Pasar Global dan Horizon Keberlanjutan Komputasi AI
Fenomena borong masal dan kanibalisasi kartu grafis kelas atas ini memicu distorsi harga yang signifikan di pasar ritel global. Saluran distribusi resmi di kawasan Asia Pasifik, Timur Tengah, dan Eropa mengalami pengeringan inventaris karena perantara pasar gelap bersedia membayar premi tunai jauh di atas harga eceran yang disarankan produsen. Bagi perakit kluster server lokal di China, membayar premi lima puluh hingga tujuh puluh persen di atas harga ritel konsumen tetap jauh lebih hemat daripada menyelundupkan akselerator enterprise B200 atau H100 yang harganya dapat melambung hingga empat kali lipat harga resmi di pasar gelap internasional. Kalkulasi belanja modal (CapEx) inilah yang menjadi penggerak ekonomi utama di balik menjamurnya industri konversi silikon skala pabrikan.
Kendati menawarkan solusi pragmatis jangka pendek, konversi kartu konsumen mengandung risiko keandalan jangka panjang yang tidak dapat diabaikan oleh para pengelola pusat data. Silikon GB202 pada lini konsumen tidak melalui proses pengujian keandalan termal kelas enterprise yang menerapkan toleransi siklus kerja penuh 24 jam sehari selama bertahun-tahun. Selain itu, absennya fitur koreksi kesalahan Error-Correcting Code (ECC) pada seluruh tingkatan hierarki sirkuit internal die dapat menimbulkan fenomena silent data corruption saat menjalankan beban pelatihan model fondasi berskala masif. Namun untuk beban kerja inferensi, inferensi batching, serta fine-tuning model berparameter menengah, toleransi terhadap kesalahan acak jauh lebih longgar, menjadikan rasio biaya per token dari kartu modifikasi ini tetap sangat kompetitif.
Pada akhirnya, fenomena konversi RTX 5090 ini menegaskan bahwa kebijakan pembatasan ekspor berbasis perangkat keras selalu menghadapi paradoks elastisitas rekayasa. Selama silikon komputasi berperforma tinggi masih diproduksi untuk pasar massal global, batasan fisik antara perangkat gaming dan akselerator kecerdasan artifisial akan selalu bisa dijembatani oleh kreativitas rekayasa tingkat bawah. Bagi industri semikonduktor dunia, siklus ini menjadi sinyal jelas bahwa perang hegemoni komputasi tidak lagi hanya berlangsung di ruang rapat perancang kebijakan atau laboratorium litografi termaju, melainkan juga ditentukan di atas meja solder dan lini perakitan kembali perangkat keras di pasar sekunder.